P versus NP: ¿es lo mismo encontrar una solución que comprobarla?

En el año 2000, Año Mundial de las Matemáticas y centenario de los problemas de Hilbert, el Instituto Clay de Matemáticas eligió siete problemas abiertos, los llamados Problemas del Milenio, y ofreció un millón de dólares por resolver cada uno. Se ha resuelto uno, la conjetura de Poincaré, que demostró Perelman. Además, en septiembre de 2026 OpenAI anunció que había resuelto el problema de Navier-Stokes, aunque la comunidad matemática aún lo está evaluando. Uno de los siete es quizás uno de los más difíciles, el problema P versus NP, y ya veremos lo que ocurre en los próximos meses.
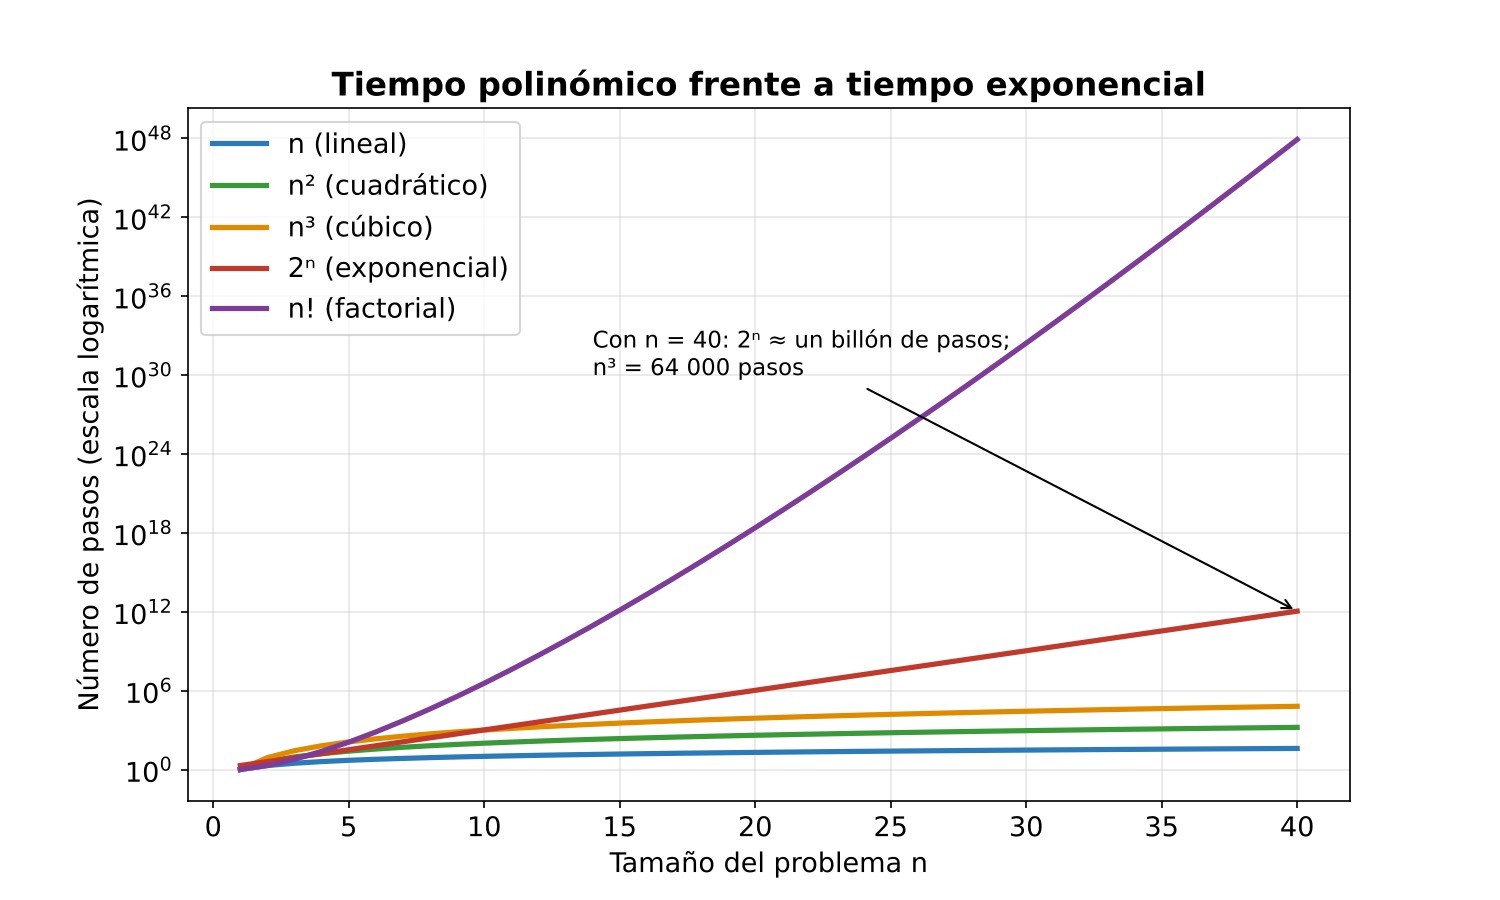
Para saber si un problema es difícil hay que ver cómo crece el tiempo que tarda un algoritmo en resolverlo a medida que crece el tamaño del problema, al que llamamos n. Buscar un nombre recorriendo una lista desordenada es lineal: si la lista es el doble de larga, se tarda el doble. Ordenar con el método escolar de comparar todos los pares es cuadrático, del orden de n². En general, cuando el tiempo crece como una potencia de n hablamos de algoritmos polinómicos. Son algoritmos que se consideran eficientes.
El crecimiento exponencial, como 2ⁿ, es otra cosa. Con n = 40, un algoritmo cúbico hace 64.000 pasos. Uno exponencial hace más de un billón. Si añadimos una sola unidad al tamaño, el trabajo se duplica, y ningún avance del hardware compensa ese ritmo.
La clase P reúne los problemas que pueden resolverse en tiempo polinómico. Por ejemplo, ordenar una lista, calcular el camino más corto entre dos ciudades en un mapa (algoritmo de Dijkstra) o decidir si un número es primo. Este último caso solo se demostró en 2002, con el algoritmo AKS, llamado así por las iniciales de sus autores, Manindra Agrawal, Neeraj Kayal y Nitin Saxena, del Indian Institute of Technology de Kanpur (India). Kayal y Saxena eran entonces estudiantes de grado, y Agrawal, su profesor.
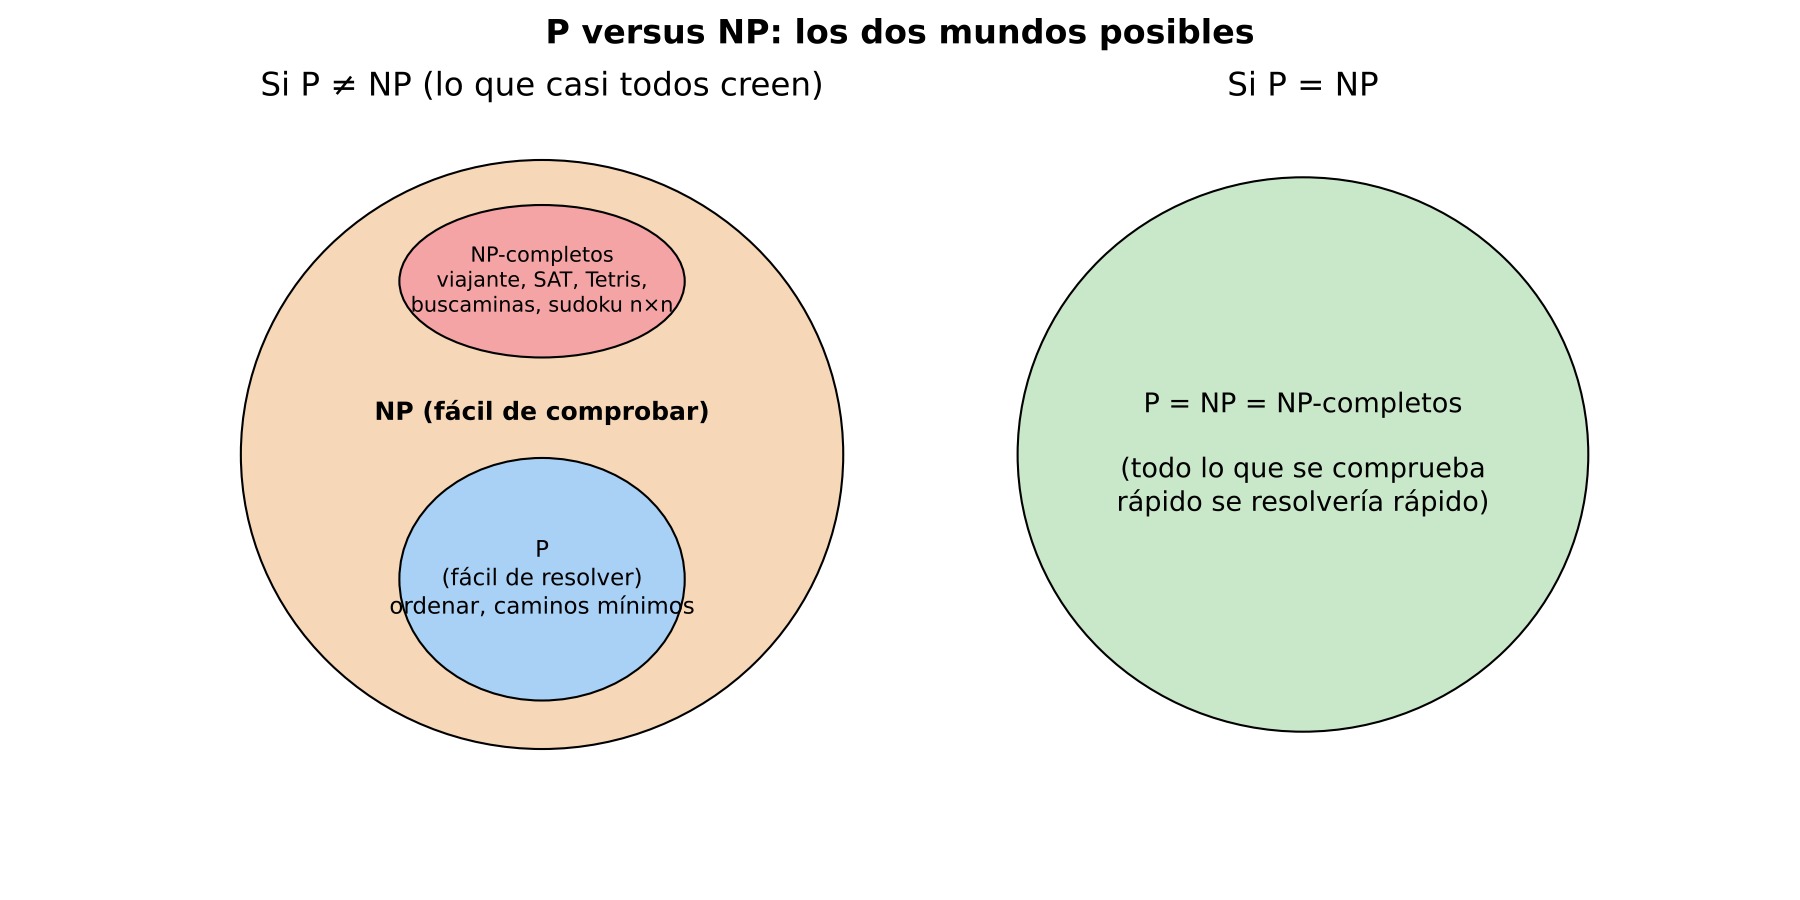
La clase NP reúne los problemas cuyas soluciones pueden comprobarse en tiempo polinómico. Es importante diferenciar los conceptos: NP no quiere decir «difícil», sino «fácil de verificar». Un ejemplo clásico es la factorización. Encontrar los dos primos cuyo producto es 8.633 obliga a probar divisores. Comprobar que 89 × 97 = 8.633 requiere una sola multiplicación. Con un sudoku pasa lo mismo: resolverlo puede costar una tarde, pero revisar una solución propuesta se hace en un minuto.
Todo problema de P está también en NP. Si sé resolver algo deprisa, puedo comprobar cualquier solución deprisa: basta con resolverlo y comparar. La pregunta del millón es la contraria: ¿todo lo que se comprueba fácilmente se puede también resolver fácilmente? Dicho de otro modo, ¿es P = NP?
En 1971, Stephen Cook (y, por su cuenta, Leonid Levin en la URSS) descubrió que dentro de NP hay problemas que son los más difíciles. Son los llamados NP-completos: cualquier otro problema de NP puede traducirse a ellos con un coste polinómico. Por eso, si alguien encontrara un algoritmo eficiente para uno solo de ellos, todos los problemas de NP quedarían resueltos de golpe.
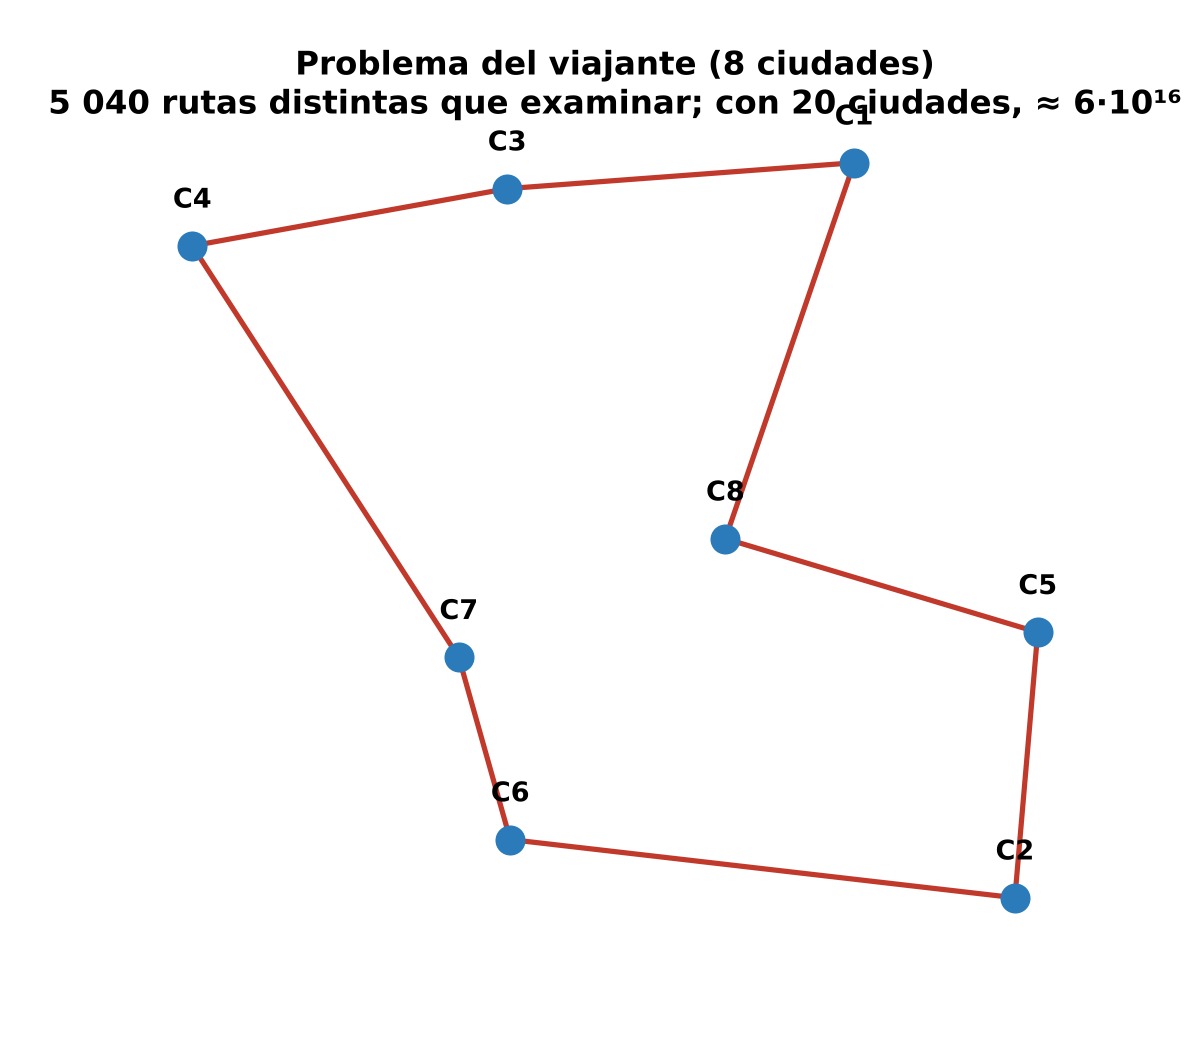
La lista de NP-completos es enorme. El más famoso es el del viajante, en su versión de decisión: ¿existe una ruta que pase por todas las ciudades con una longitud menor que una cota dada? Con 8 ciudades hay 2.520 rutas posibles. Con 20, unas 6·10¹⁶. También está SAT, que pregunta si una fórmula lógica puede hacerse verdadera, y varios juegos. El Tetris, cuando se conocen de antemano todas las piezas, es NP-completo (Demaine y colaboradores, 2002). También lo es decidir si un tablero del buscaminas es coherente (Kaye, 2000), y lo mismo ocurre con el sudoku generalizado a tableros de n²×n² (Yato y Seta, 2003).
Casi todos los especialistas creen que P ≠ NP. Si resultara que P = NP, mucho de lo que damos por seguro dejaría de serlo. La criptografía que protege nuestras transacciones bancarias se apoya en que ciertos problemas son fáciles de verificar y difíciles de resolver. Por otro lado, la logística, el diseño de fármacos y la propia demostración de teoremas se volverían tareas casi automáticas. En principio, una demostración breve sería tan fácil de encontrar como de leer.
Desde hace cincuenta años sabemos qué métodos no sirven. La relativización (Baker, Gill y Solovay, 1975), las «pruebas naturales» (Razborov y Rudich, 1994) y la algebrización (Aaronson y Wigderson, 2008) son barreras demostradas: ninguna técnica que caiga dentro de esas familias puede separar P de NP. La de las pruebas naturales se apoya en que existan funciones pseudoaleatorias seguras, las mismas que necesita la criptografía. Mientras tanto, arXiv recibe cada año varias «demostraciones», unas de P = NP y otras de P ≠ NP. En 2025 hubo varias, algunas incluso acompañadas de verificaciones en Lean. Ninguna ha convencido a la comunidad.
Ha habido progresos reales, aunque laterales. En 2025, Ryan Williams (MIT) demostró que todo cálculo que tarda un tiempo t puede hacerse con una memoria de solo √(t log t). Es una mejora enorme sobre el resultado de Hopcroft, Paul y Valiant, de hace cincuenta años, y supone un pequeño paso en el problema vecino de P versus PSPACE. Además, el campo de la metacomplejidad investiga cuán difícil es demostrar que algo es difícil.
La IA ya participa en la teoría de la complejidad. En 2025, investigadores de Google usaron AlphaEvolve, un agente que hace evolucionar código con modelos de lenguaje, para descubrir «artilugios» combinatorios finitos. Al insertarlos en demostraciones ya conocidas, obtuvieron nuevos resultados de inaproximabilidad para MAX-k-CUT y para el viajante métrico. Y lo más importante: esas estructuras se verifican por ordenador, sin depender de la confianza en la máquina.
Y en octubre de 2026, OpenAI y Anthropic anunciaron, cada una por su lado, que sus modelos habían refutado la hipótesis del tiempo exponencial (ETH). Esta hipótesis, propuesta por Impagliazzo y Paturi en 1999, sostiene que el problema 3-SAT no puede resolverse en tiempo subexponencial. Las dos pruebas vienen verificadas en Lean y la comunidad las está revisando. Si se confirman, sería un resultado de gran calado, pero no implicaría que P = NP: un algoritmo subexponencial puede seguir siendo enormemente lento.
Pero hay que medir bien lo que esto significa. La IA generativa sirve para explorar espacios enormes de casos y para formalizar demostraciones. P versus NP pide otra cosa: una idea nueva, capaz de esquivar las barreras que ya conocemos. ¿Podrá una IA tenerla? Nadie lo sabe. Hay incluso una ironía en la pregunta: si P fuera igual a NP, encontrar demostraciones sería fácil y la IA lo tendría todo a su alcance. Lo más probable es que, si llega una solución, sea fruto de la colaboración entre matemáticos humanos, IA generativa y asistentes de demostración formal. Y como en todo problema de NP, comprobar esa demostración será mucho más fácil que encontrarla.
_________________
Manuel de León (CSIC, Fundador del ICMAT, Real Academia de Ciencias, Real Academia Canaria de Ciencias, Real Academia Galega de Ciencias, Presidente del ICM2006 Madrid y miembro del Comité Ejecutivo de IMU (2007-2024) y del Comité Ejecutivo del ISC (2014-2018). Web: https://www.manueldeleon.es